機械学習の評価指標
機械学習のモデルを評価するための方法や指標を紹介。
- 2値分類モデルの検証、評価方法
- 分類性能の評価指標(Accuracy, Precision, Recall, F1-scoreなど)
- 識別性能の評価指標(ROC-AUC, PR-AUC)
サンプル事例
- カフェチェーンの顧客別購入データが約3ヶ月分ある。
- 誰が「ラテ」を購入するかを予測したい(買う/買わないの2値分類予測をLightGBMで)。
- 予測結果をもとに、ラテを購入しそうな顧客を次の施策対象としたい。
    Python 3.11.15
    OS macOS-26.5.1-arm64-arm-64bit
    pandas 3.0.2
    numpy 2.4.3
    matplotlib 3.10.9
    seaborn 0.13.2
    scikit-learn 1.8.0
    shap 0.51.0
    lightgbm 4.6.0
データの分割
機械学習では、データを役割に応じて3つに分けて使うことがある。
- Train(学習用): モデルの学習に直接使う。
- Validation(検証用): 学習中のモデルの性能を確認し、Early Stoppingやパラメータ調整などに使う。
- Test(評価用): すべての調整が終わった後、初見のデータに対してどのくらい性能を発揮できるか、最後に確認するために使う。
例えば、70, 15, 15に分けたり、まず80と20(Test用)に分けて、その80をさらにTrain 80, Validation 20(つまりTrain64, Val16, Test20)に分けたりする。
Validationを設ける意義
- Early Stopping
- LightGBMなどでは、学習を繰り返すほど学習データに対する性能は向上しますが、学習しすぎると過学習が起こり、未知のデータに対する性能が低下することがある。
- そこで、Validationデータに対する性能が改善しなくなったところで学習を止めることで、過学習を抑えながら、適切な学習状態でモデルを止めることができる。
- Testデータへの「カンニング」を防ぐ
- もしTestデータを使って学習を止めるタイミングやパラメータを決めてしまうと、知らず知らずのうちにTestデータに都合のよいモデルを作ってしまう。
- そのため、モデルの調整に使うValidationと、最後までできるだけ触れずに取っておくTestを分けておく。
- 未知のデータに対する性能を確認する
- 時系列データでは、単純にランダムに分割するのではなく、時間の順序を保ってTrain/Validation/Testを分けることがある。
- 例えば、TrainとTestの期間が隣接していると、特定の期間の傾向に適合したモデルになってしまい、その後の期間では性能が低下する可能性がある。
- そこで、TrainとValidation、ValidationとTestの間に一定の期間を設けることで、より未来に近い条件でモデルの性能を確認する方法もある。
このように、ValidationやTestを適切に分けることで、学習に使っていない未知のデータに対してもモデルがどの程度通用するのかを確認できる。
Validationを設けない場合
- Validationは必ず独立したデータとして用意しなければならないわけではない。
- モデルの調整をおこなわず、TrainデータとTestデータだけで構成する場合もある。
- また、Cross Validationを使う場合は、データを複数の組み合わせに分け、それぞれの検証用データを入れ替えながらモデルを評価できる。この場合、固定したValidationデータを別途用意する必要はない。
- 一方、モデルのパラメータ調整やEarly Stoppingなどをおこなう場合は、その判断に使うValidationデータと、最終評価に使うTestデータを分けておくことが重要。
評価指標用のデータ
モデルの調整中に評価指標を見る場合は、基本的にはValidationデータを用いる。
# 検証データで評価
y_pred_val = model.predict_proba(X_val)[:, 1]

# モデルの調整がすべて終わり最終的な性能を確認するときはTestデータで評価
y_pred_test = model.predict_proba(X_test)[:, 1]

# 学習データ(Train)についても評価指標を計算することはできる
y_pred_train = model.predict_proba(X_train)[:, 1]
ただし、学習データでの評価結果は、モデルが実際に学習したデータに対する性能。未知のデータに対する性能を見るValidationやTestとは意味が異なる。
Trainの評価結果を見てモデルをチューニングすることは通常ない。学習データに対して良い結果になるよう調整してしまうと、過学習を見逃す可能性があるため。
分類性能の評価
モデルが最終的に「1」か「0」かを予測した結果を評価する。実際の結果と予測結果を組み合わせると、2×2の混同行列として整理できる。対角線上のセルが多いほど、正しく分類できた件数が多い。
| 予測: 負例 | 予測: 正例 | |
|---|---|---|
| 実際: 負例 | TN(True Negative) | FP(False Positive) |
| 実際: 正例 | FN(False Negative) | TP(True Positive) |
混同行列(Confusion Matrix)の各象限
- TP (True Positive 真陽性): 正例を正しく正例と予測したもの → 実際に買った人を、正しく買うと予測してた
- FP (False Positive 偽陽性): 負例を誤って正例と予測したもの → 実際には買わなかった人を、誤って買うと予測してた
- FN (False Negative 偽陰性): 正例を誤って負例と予測したもの → 実際に買った人を、誤って買わないと予測してた
- TN (True Negative 真陰性): 負例を正しく負例と予測したもの → 実際には買わなかった人を、正しく買わないと予測してた
混同行列における配置は常に同じとは限らないので、場所で覚えちゃダメ
- True / False = 予測が正しかったか
- True: 予測が正しかった
- False: 予測が間違っていた
- Positive / Negative = 何を予測対象としているか
- Positive: 関心のあるクラス(購入する)
- Negative: それ以外(購入しない)
- 正例 / 負例 = ラベルが1か0か
- 正例: ラベルが1(買った、買う)
- 負例: ラベルが0(買わなかった、買わない)
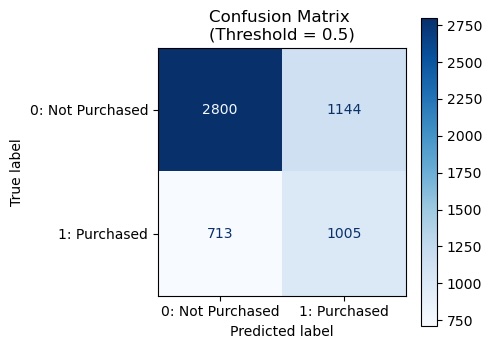
サンプル事例での結果は、合計5,662人のうち実際の購入者は1,718人(出現率30%)、非購入者は3,944人。この4セルのどこに注目するか。
TP (True Positive):  1005 件
TN (True Negative):  2800 件
FP (False Positive): 1144 件
FN (False Negative): 713 件
Accuracy
すべての予測対象のうち、正しく予測できた割合(正解率)。
Accuracy = (TP + TN) / (TP + TN + FP + FN)
- 意味が直感的に理解しやすい。少数派を無視するリスクを許容する。利用場面を選ぶ。
- 基本姿勢: 全体として正しく予測することを重視したい。
- 許容リスク: 状況次第では使いにくい(買う人の出現率低い場合は全員買わないと予測すれば高い値になる。だがあまり役には立たない)。
- 例: コイントスで表が出るかを予測(表裏の出現率はほぼ半々で、表を予測するのと裏を予測するのは同じ価値とみなしやすい)。
Accuracyは数値の意味がわかりやすく、モデルの基本的な予測性能比較など有用な場面もある。
- だがビジネスにおいては正例の予測が重要なことが多い。
- 「買わない」と予測して実際に買わなかったことが予測できても、「買う」の予測ほどには利潤や事業成長に直結しにくいため。
- また予測対象はクラス不均衡なことも多い(自社の特定商品購入者は市場のごく一部など、正例と負例の出現率は偏りがち)。
- そんなときはPrecisionやRecallの出番。
Precision
正例と予測した対象のうち、実際に正例だった割合(適合率)。
Precision = TP / (TP + FP)
- 効率優先。機会損失リスク許容。外したくない慎重さ。
- 基本姿勢: 正例を精度高く予想したい。買う(正例)の予測はなるべく外したくない。確度低い人へのアプローチは避けたい。
- 許容リスク: 正例と予測する数は少なくてもいい。買う期待値の低い人は切り捨てる。獲得数や売上最大化の逸失を許容。
- 例: コストがかさむDM送付施策など。徒労に終わりそうな100人のアプローチよりは確実に買いそうな10人を優先したい。
Recall
実際は正例の対象のうち、正しく正例と予測できた割合(再現率)。
Recall = TP / (TP + FN)
- 網羅性優先。低効率リスク許容。取りこぼさない貪欲さ。
- 基本姿勢: 正例を取りこぼしなく予測したい。買う(正例)期待値が低くとも抜け漏れよりはマシ。確度が低い人でもアプローチしたい。
- 許容リスク: 無駄打ち増える。ROI低下を許容。買う(正例)の予測は外れてもよい。狼少年呼ばわりされるリスク(誤検出や無駄打ちが増えること)を許容。
- 例: 低コストなプッシュ通知施策や病気の検診など。買う見込みが薄い100人にアプローチしてでも取りこぼさないことを優先したい。
PrecisionとRecallのトレードオフ
2値分類モデルは基本的に、正例である確率(0.0〜1.0)を出力する。これを人間が判断しやすい二択のラベル(0/1)に振り分けてる。
しきい値(threshold)を0.5(一般的なデフォルト値)にするとは、すなわち、確率0.5以上は「1:購入する」と予測、確率0.5未満は「0:購入しない」と予測したものとみなす、という意味。なお0.5は「正例と予測する確率が半分以上」という直感的な(自然な)基準であり、常に最適なしきい値というわけではない。
しきい値を高くすると、かなり確信のある人だけを正例とするため、Precisionは高くなりやすい。そのぶん正例と予測する人数が減るので、Recallは低くなりやすい。
逆に、しきい値を低くすると、少しでも購入可能性があれば正例とするため、Recallは高くなりやすい。ただし実際には買わない人も多く含まれるため、Precisionは低くなりやすい。
- Precision:予測した正例をどれだけ確実に当てられるか
- Recall:実際の正例をどれだけ取りこぼさず見つけられるか
例えば、予定しているクーポン配布施策の予算が潤沢にあるなどの理由で、買う確率が0.3ぐらいの人もクーポン配布対象にしたいなどのビジネス判断が先にある、検討余地がある場合には、しきい値を0.5ではなく0.3にして評価するという手もある(詳細後述)。
つまり、しきい値を動かすことでもPrecisionとRecallの値は変わるため、「何のための予測なのか」「何を重視したいのか」が明確になってないと、モデルの評価、判断もしにくい。
F1-score
PrecisionとRecallの両方を考慮したい場合に。
F1 = 2 * (Precision * Recall) / (Precision + Recall)
- 総合力優先。中庸リスク許容。慎重さと貪欲さのバランス。
- 基本姿勢: PrecisionもRecallも重視したい(トレードオフな両方のバランスをとりたい)。両方を1つの指標で評価したい。
- 許容リスク: 2指標いずれかに特化すれば得られたはずのハイパフォーマンスな効率性または網羅性には振り切らないことを許容。
- 例: 効率も網羅性もどちらも適度に両立したい。どちらかに極端に偏るのも、どちらかが極端に低くなるのも避けたい。
PrecisionとRecallからF1へのつながり
- PrecisionとRecallはトレードオフの関係にある。
- Precisionを1(100%)に近づけたいなら、予測確率の判定基準であるしきい値を1に極力近づけて、確実に買いそうな人だけを少数予測すればいい。代償として、Recallは低くなる。
- 逆に、Recallを1に近づけたいなら、しきい値を0側にレバー倒して、ほぼ全員買うと予測すればいい。ただしPrecisionはズタズタになる。
- こういう極端なことなしに、どちらもほどほどに両立した状態を1つの指標で表せられたらいいのに。。。
対処策1
- まず思いつくのは、PrecisionとRecallを足して2で割る、つまり平均化する発想。 (Precision + Recall) / 2
- でもこれだと、Precision0.95 Recall0.15のときも、Precision0.15 Recall0.95のときも、平均は0.55となる。
- 片方が極端でもまあまあな数値に見えてしまう。足して2で割る発想自体はよくても、欲しい状態を的確に表す指標にはなってない。。。
対処策2
- 目指したいのは、両方の値のバランスが良いときは高得点になり、いずれかが極端な値のときはペナルティが大きくなるような仕組み。
- どちらの値も0から1(0%から100%)の範囲内にある。であれば0に近いときは大きく減点すれば、欲しい状態を的確に表せるのではないか。
- そこで2つの値それぞれの逆数をとってから平均化する発想。 (1/Precision + 1/Recall) / 2
- これだと、Precision0.95 Recall0.15のときは、(1/0.95 + 1/0.15) / 2 = 3.68
- 逆数をとった値の平均値は元の単位と違ってて解釈しにくいので、改めて逆数をとって元の単位に戻す。1 / 3.68 = 0.27
- 同じ計算をPrecision0.75 Recall0.35でやると、(1/0.75 + 1/0.35) / 2 = 2.10 の逆数で 0.48
- 同じ計算をPrecision0.65 Recall0.45でやると、(1/0.65 + 1/0.45) / 2 = 1.88 の逆数で 0.53
- 同じ計算をPrecision0.60 Recall0.55でやると、(1/0.60 + 1/0.55) / 2 = 1.74 の逆数で 0.57
- 欲しい状態を的確に表す指標になったっぽい。これがF1-score
- 数学でいう調和平均の計算方法を、機械学習の評価指標として使っている。
F1 score = 1 / { (1/Precision + 1/Recall) / 2 }
         = 2 / { (1/Precision) + (1/Recall) }
         = 2 / { (Recall + Precision) / (Precision * Recall) }
         = 2 * Precision * Recall / (Precision + Recall)
なお、PrecisionとRecallのどちらかを明確に重視したい場合には、F1-scoreを拡張したFβ-scoreという指標もある。βを大きくするとRecall、小さくするとPrecisionをより重視した評価になる。
ただし、どの程度の重み付けが適切かは用途によって異なる。実務では、Fβ-scoreという1つの数値にまとめるよりも、PrecisionとRecallを個別に確認し、施策コストや取りこぼしの損失を考慮して判断するほうがわかりやすい場面も多い。
MCC
「このモデルは、正例と負例を本当に区別できているのか?」を確認したいときに役立つ指標。
Precision, Recall, F1-scoreは主に正例に注目した指標。対してMCCは、混同行列の4セルすべてを使って、実際のクラスと予測クラスの一致関係を評価する指標(実際と予測の相関係数)。Matthews Correlation Coefficient
MCC = (TP × TN − FP × FN) / √{(TP + FP)(TP + FN)(TN + FP)(TN + FN)}
mcc = (tp * tn - fp * fn) / math.sqrt((tp + fp) * (tp + fn) * (tn + fp) * (tn + fn))
# 一気に計算する場合、モデルが全員を同じクラスに予測した時などに、分母が0になるケースがある

# 分子の計算: (TP * TN) - (FP * FN)
mcc_numerator = (tp * tn) - (fp * fn)
# 分母の計算: sqrt((tp+fp) * (tp+fn) * (tn+fp) * (tn+fn))
mcc_denominator = math.sqrt((tp + fp) * (tp + fn) * (tn + fp) * (tn + fn))
# 分母が0の場合はMCCを0とする(ライブラリ次第)
if mcc_denominator == 0:
    mcc = 0
else:
    mcc = mcc_numerator / mcc_denominator

print(f"MCC (Matthews Correlation Coefficient): {mcc:.3f}")
- 分母: 予測側と実際側それぞれの正例・負例の分布を考慮して正規化している。予測Positive数、実際Positive数、実際Negative数、予測Negative数の積の平方根(正例と負例のバランスをとって平方根をとることで値が大きくなりすぎないようにしている)。
- 分子: 正しい分類を表すTP×TNから、誤分類を表すFP×FNを差し引く。前者が多いほど分子が大きくなる。これにより実際と予測の相関が強いことを表現する。
- 正例と負例を完全に入れ替えても値が変わらない(対称性がある)。
MCCのとる範囲は-1から1の間。
- 1に近い: うまく予測してる。
- 0に近い: デタラメ(ランダム)と同じ。
- -1に近い: 全部逆に予測してる(ある意味すごい)。
正例と負例の両方を考慮するため、クラス不均衡な場合にも、モデルの分類性能をシビアに評価しやすい(多数派のクラスで正答を稼いだ高Accuracyなモデルでも、MCCは高くなりにくい)。
Balanced Accuracy
クラス不均衡でも、正解率をシンプルかつ公平に評価したい場合に(均衡正解率)。
Balanced Accuracy = (Recall + Specificity) / 2
Specificity(特異度) : 実際は負例の対象のうち、正しく負例と予測できた割合(真陰性率) Specificity = TN / (TN + FP)
- つまり、正例についての正解率(Recall)と、負例についての正解率(Specificity)を、正例・負例の出現率に関係なく、正例と負例を同じ重みで評価している。
- クラス不均衡があるデータで「正例と負例を公平に評価したい」ときに便利。
- 正例と負例を同じ重みで評価したときの正解率です、と説明しやすいしわかりやすい。
同じ重みとは? 例えば正例の出現率が1%で、かつ正例のみに関心がある場合に、1%しかない大事な貴重な正例を半分見逃すのと、99%の負例(不要なもの)を半分拾いすぎるのを、同程度にダメ出しするようなこと。
逆に言えば、AccuracyはRecallとSpecificityを出現率で重み付けしている(がために正例・負例の出現率次第で、数値の見え方、評価の基準が変わってくる)。
Accuracy = ( TP + TN ) / Total
         = ( TP / Total ) + ( TN / Total )
         = { TP / (TP+FN) * (TP+FN) / Total } + { TN / (TN+FP) * (TN+FP) / Total }
         = (Recall * 正例出現率) + (Specificity * 負例出現率)
その他の指標
4セルの組み合わせ次第で、他にもいろんな指標が算出可能。似たものにも見えるが、分母の捉え方がちょっとずつ異なる。
| 指標 | 式 | 意味 | 補足 |
|---|---|---|---|
| NPV (Negative Predictive Value) | TN / (TN + FN) | 負例と予測した対象のうち、実際に負例だった割合(陰性的中率) | Precisionの裏に相当。負例にあまり関心がない場面では影が薄い。精密機器の良品判定(不良品と予測して実際に不良品でした)などで有用。 |
| Specificity | TN / (TN + FP) | 実際は負例の対象のうち、正しく負例と予測できた割合(真陰性率)。 | Recallの裏に相当する。スパム判定(大事なメールを間違えてゴミ箱に入れない)などで有用。負例を精度高く予想したい、負例を正しく負例としたいときに。 |
| FDR (False Discovery Rate) | FP / (TP + FP) | 正例と予測した対象のうち、実際は負例だった割合(偽発見率) | 分母はPrecisionと同じ。Precisionの余事象に相当(FDR = 1 - Precision)。 |
| FPR (False Positive Rate) | FP / (TN + FP) | 実際は負例の対象のうち、誤って正例と予測した割合(偽陽性率) | 分母はSpecificityと同じ。Specificityの余事象に相当(FPR = 1 - Specificity)。のちほど登場する指標ROC曲線、ROC-AUCに関わってくる。 |
| FNR (False Negative Rate) | FN / (TP + FN) | 実際は正例の対象のうち、誤って負例と予測した割合(偽陰性率) | 分母はRecallと同じ。Recallの余事象に相当(FNR = 1 - Recall)。見逃し(False Negative)がクリティカルに直結する(命に関わる)ような医療現場などで有用。 |
Cohen's Kappa(カッパ係数)
MCC同様に実際のクラスと予測クラスの一致度を評価する指標。違いは、偶然による一致を考慮する点。実際と予測が一致したのは、モデルの実力なのか、それともたまたまなのか。たまたま当たったぶん(期待値)を全体から引いて、純粋な予測の重みを評価する。
クラスの出現率割合と予測割合から「偶然でもこれくらいは一致しそう」という一致率を考え、その分を差し引いて評価する。
- 実測の一致率: 実際に予測が当たった割合(つまりAccuracy)。
- 偶然の一致率: 事実もモデルも、お互いデタラメに(でも出現率通りに)答えたときに、偶然重なっちゃう確率。
- この2つを使って計算する。Kappa = (実際の一致率 − 偶然の一致率) / (1 − 偶然の一致率)
Cohen's Kappaのとる範囲は-1から1の間。
- 1: 完全な一致(予測が当たったのは全てモデルの実力)。
- 0: 偶然による一致と同程度(偶然当たってるだけ。目をつぶって選んでるのと変わらない)。
- 0未満:偶然よりも一致度が低い(偶然よりも当たってない。逆にすごい)。
ただし、クラスの偏りや予測割合によって値が影響を受ける場合があり、機械学習の分類性能評価では、MCCやBalanced Accuracy、Precision/Recall系の指標のほうが解釈しやすいことが多い。
# 1. 数値をセット
total = tp + tn + fp + fn

# 2. po (実際の正解率)
po = (tp + tn) / total

# 3. pe (偶然当たっちゃう確率)
# 「モデルの正例予測数 × 実際の正例数」 + 「モデルの負例予測数 × 実際の負例数」 を Totalの2乗で割る
pe = ((tp + fp) * (tp + fn) + (tn + fn) * (tn + fp)) / (total ** 2)

# 4. Kappaの計算
kappa = (po - pe) / (1 - pe)

# これでもOK
# from sklearn.metrics import cohen_kappa_score
# kappa = cohen_kappa_score(y_val, y_class_pred)

print(f"Cohen's Kappa: {kappa:.3f}")
ここまでの指標をどう使い分けるか
| 指標 | 値 | 何を見てるか |
|---|---|---|
| Accuracy | 0.672 | 全体として、どれだけ正解したか |
| Precision | 0.468 | 正例と予測した人を、どれだけ確実に当てられたか |
| Recall | 0.585 | 実際の正例を、どれだけ取りこぼさずに拾えたか |
| F1-score | 0.520 | PrecisionとRecallを両立できているか |
| MCC | 0.279 | 正例・負例を含め、分類が全体としてどれだけ正しく対応しているか |
| Balanced Accuracy | 0.647 | 正例・負例を同じ重みで評価した正解率 |
ただし、これらの指標の多くは、どのしきい値で0と1を分けるかによって値が変わる。そのため「何のために予測するのか」「PrecisionとRecallのどちらを重視するのか」を決めずに、数値だけを比較してもモデルの良し悪しは判断しにくい。
- 「良いモデルかどうか」は指標を1つ見れば決まるわけではない。
- 何を重視するかによって、適切な評価指標も変わる。
しきい値によらない識別性能
- Accuracy, Precision, Recall, F1などは、ある1つのしきい値で0/1に分類した結果を評価する指標である。
- しかし分類モデルは本来、各対象に「正例らしさ」を表すスコアを出力している。
- そこで、しきい値を固定せずに動かしながら、正例と負例をどれだけうまく順位付けできているか(識別できているか)を評価する方法がROC曲線やPR曲線である。
ROC曲線
ROC曲線は、分類のしきい値を変化させたときの、
- TPR(True Positive Rate)= Recall
- FPR(False Positive Rate)= FP / (TN + FP)
の関係を表した曲線。Receiver Operating Characteristic Curve)
これを2次元の平面に表現する。
- 縦軸 TPR: 実際は正例の対象のうち、正しく正例と予測できた割合(=Recall)
- 横軸 FPR: 実際は負例の対象のうち、誤って正例と予測した割合
ROC曲線のプロット手順
顧客 購入確率
A 0.95(実際:1)
B 0.88(実際:1)
C 0.75(実際:0)※間違い、空振り
D 0.60(実際:1)
E 0.55(実際:1)
F 0.42(実際:0)※間違い、空振り
G 0.38(実際:1)
H 0.30(実際:0)※間違い、空振り
I 0.20(実際:1)
J 0.10(実際:0)※間違い、空振り
(データ10人分での例)
- 予測確率が高い順にデータを並べる。
- モデルが「この人は買いそう」と判定した確率が高い順に上から下へ並び替える。
- しきい値を上から下に「スライド」させる。
- 並び替えたデータのすき間に、上から順番に「しきい値の線」を引いていく。
- 最初に、一番上に線を引く(しきい値1.0)
- 誰も「1」とは予測しない、超ドケチな設定。
- TPR(真陽性率:見落とさず当てた割合)=0 (誰も当ててない)
- FPR(偽陽性率:間違えて空振りした割合)=0 (誰も予測してないから空振りもゼロ) グラフの座標は (0, 0) からスタート!
- 1番目のAの下に線を引く(しきい値0.90)
- 「Aだけを1、残りを全員0」と予測する設定。
- Aは実際に1で、見落とさずに当てられたから、TPR(縦軸)が上にピョコッと1歩上がる。
- 空振り(実際は0なのに1と予測する)はしていないから、FPR(横軸)は動かない。
- 3番目のCの下に線を引く(しきい値0.70)
- 「A、B、Cを1、残りを0」と予測する設定。
- Cは実際には0(買わなかった)だから、モデルの予測はハズレ(空振り)。
- このときは、FPR(横軸)が右にピョコッと1歩進む。(縦軸は動かない)
- 最後まで繰り返して線を結ぶ
- これを一番下の「全員を1と予測する超ゆるゆる設定(しきい値0.0)」まで繰り返すと、最終的にグラフの右上 (1, 1) にゴールする。
- この「本物が来たら上に1歩、空振りなら右に1歩」と動いていった足跡を繋いだのがROC曲線
ROC曲線における良いモデルと悪いモデル
- 優秀なモデルの場合
- 確率が高い順に並べ替えたとき、上のほうに「本物の1」がズラッと並ぶ。
- ということは、しきい値を下げていくとき、最初は「上にピョコピョコピョコ!」と連続で上がって、本物を全部回収しきってから、
- 最後に「右にトコトコ…」と進んでゴールに向かう。
- 結果として、グラフは左上に大きく膨らんだ、理想的な曲線(AUCが1に近づく)になる。
- 完全にランダム(でたらめ)なモデルの場合:
- 確率順に並べても、「1」と「0」がぐちゃぐちゃに混ざっている。
- しきい値を下げていくと、「上、右、上、右、右、上…」と交互に進むことになるから、
- グラフはおおむね左下から右上に向かって斜め45度の直線(AUC=0.5)になっちゃう。
ROC曲線の特性
- 人間がどこに境界線を引くべきか(実務上の都合でしきい値をいくつに設定するか)を決める前に、モデルが1と0をきれいに並び替える能力があるか、すなわち「1と0の識別能力」を視覚化したもの
- 縦軸は正例だけでの正解率、横軸は負例だけでの間違い率と、正例と負例を独立させた集計値をみている。したがって、目的変数1/0の比率(購入者の割合)が変わっても、ROC曲線の形状には影響しにくい。
ROC-AUC
ROC曲線を描いて、その下の面積を全部足し算(積分)した値。AUC(Area Under the Curve)
ROC-AUCは0から1の値をとり、
- 1.0: 正例と負例を完全に識別できる
- 0.5: ランダム(でたらめ)な順位付けと同程度
- 0.5未満: 逆方向に順位付けしている傾向がある と解釈できる。
以下のような解釈も成り立つ。
- ランダムに1人の正例と1人の負例をペアで選んだとき、モデルが「正例のほうが正例らしい」とモデルが正しく判定(順位付け)できる確率
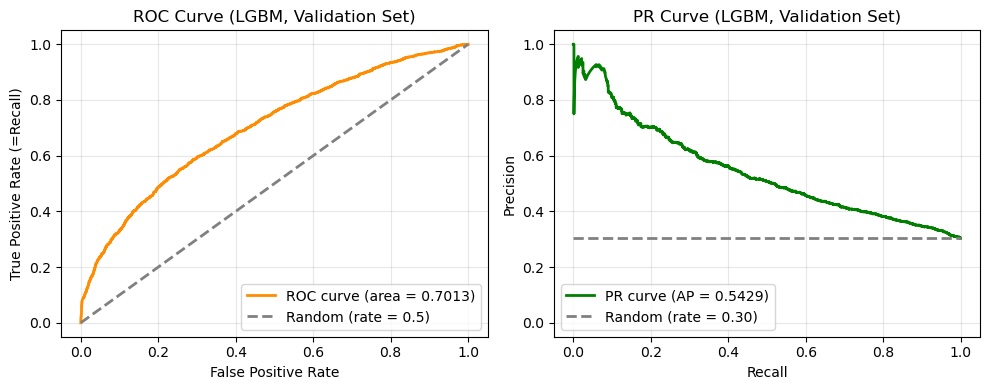
- 例えばROC-AUCが0.70なら、ランダムに選んだ正例と負例のペアについて、前者(正例)の方により高いスコアを付けられる確率は70% → 当てずっぽうよりは正しく見抜ける、それなりに役に立ちそうな予測モデルだろう
過去に提案された教科書記載などから、AUCが 0.7以上なら実用的、0.8を超えたら優秀、といった目安はあるものの、機械的に適用するのは避けるべし。
なぜなら、どの程度の識別能力が必要なのかは、当然ながら用途やデータ、誤分類による損失によって変わるため。
ラテ購入などのように人間の気まぐれな行動に左右されやすい予測が困難な場面もあれば、品質管理や命に関わる場面などもある。
ROC-AUCの強みと注意点
- 正例と負例を独立させて等しく扱っているぶん、モデルの基本的な予測性能(純粋な識別能力)が理解しやすい。
- 正例・負例それぞれの割合ではなく、両クラスをどれだけ区別できるかを見るため、クラス比率そのものの影響を受けにくい。
だがビジネス場面においては、ROC-AUCだけでは判断材料不足な場合もある。
ビジネス場面では、
- 正例の予測が重要なことが多い(買わないと予測して正解だったとしても、買うとの予測ほどには利潤や事業成長に直結しにくい)。
- 予測対象はクラス不均衡なことも多い(自社の特定商品購入者は市場のごく一部など、正例と負例の出現率は偏りがち)。
- 負例が非常に多い場合、FPがある程度増えてもFPRが大きくなりにくい。そのため、実務上は無視できない数のFPが発生していても、ROC曲線だけではそのコスト感が見えにくい場合がある。
- FPRの分子(FP: 買うと予測したが間違ってた数)が多いモデルをもとに施策をおこなうと、空振りのぶんだけコストがかさむ。
そこで、
- 確実に買いそうな人だけに絞ってコストを抑えたい施策もあることを考慮したい。
- つまり、正例に注視したい。
となると、Recallは据え置きつつ、正例を正確に予測したい→Precisionも重視したい、との観点が台頭してくる。
PR曲線
PR曲線(Precision-Recall Curve)は、分類のしきい値を変化させたときの、
- Precision: 正例と予測した対象のうち、実際に正例だった割合(縦軸)
- Recall: 実際は正例の対象のうち、正しく正例と予測できた割合(横軸)
の関係を表した曲線。これを2次元の平面に表現する。上にいくほど、(買う予測はなるべく外さないことで)ムダ打ちが少なく、右にいくほど取りこぼしが少ない。
PR曲線の特性
- 正例を対象とした施策を考える場合に、PrecisionとRecallのバランスを直接確認できる。
- 特にクラス不均衡が大きい分類問題では有用。
PR-AUC
ROC曲線を描いて、その下の面積を全部足し算(積分)した値。正例を見つける能力に焦点を当てた識別性能を表す指標。
| 指標 | 意味 | サンプル事例 |
|---|---|---|
| ROC-AUC | モデルの基本的な予測性能(純粋な識別能力) | 購入者と非購入者を全体としてどれだけうまく識別できるか |
| PR-AUC | 正例を見つける能力に焦点を当てた識別性能 | 購入者を見つけるときに、どれだけ効率よく購入者を拾えるか(正例を多く見つけつつ、誤検出を抑えられるか) |
PR-AUCとAverage Precision
PR曲線を描いて、その下の面積を全部足し算(積分)した値。その代表的な方法がPR-AUCだけども、「PR-AUC」と「Average Precision(AP)」は同じものとは限らないことに注意。
Precision-Recall曲線の面積を単純に台形公式などで計算する方法と、scikit-learnのaverage_precision_scoreのように、Recallの変化量を重みとしてPrecisionを平均する方法では、結果が異なる場合がある。
なので、PR-AUCという言葉だけで済ませず、どの方法で曲線を要約した値なのかを示す、確認するのも大事。
ROC-AUCとPR-AUCの使い分け
どちらが優れているというものではなく、注目するポイントが異なる。
| ROC-AUC | PR-AUC | |
|---|---|---|
| 注目するもの | 正例と負例の識別能力 | 正例をどれだけ正確に拾えるか |
| 縦軸 | Recall(TPR) | Precision |
| 横軸 | FPR | Recall |
| クラス不均衡 | 影響を受けにくい | 正例割合の影響を受ける |
| 向いている場面 | 全体的な識別能力を確認したい | 正例が少なく、正例の予測精度を重視したい |
サンプル事例のように「明日ラテを買う可能性が高い人を見つけ、その人たちに何らかの施策をおこなう」という用途なら、PrecisionとRecallのバランスは特に重要。そのため、ROC-AUCだけで「このモデルは良い」と判断するのではなく、PR曲線やPR-AUCも確認する必要がある。
さらに実際の施策では、
- 1人にアプローチするコスト
- 1人が購入した場合の利益
- 取りこぼしによる機会損失
- どの程度の人数まで施策対象にできるか
なども考慮して、最終的なしきい値を決めることになる。
評価指標は、モデルに「何点だったか」を付けるためだけのものではない。「このモデルを実際にどう使うのか」を考え、その目的に合った指標を選ぶことが重要。
またモデルの評価とは別に、モデルを「解釈する技術」も重要性が高まっている。詳細は機械学習モデルの解釈を参照。